La pregunta que nadie quiere hacerse en voz alta
Hay una pregunta que flota en cada stand-up, en cada retrospectiva, en cada after-office de ingenieros informáticos en 2026. Nadie la formula completa, pero todos la sienten:
¿Cuánto tiempo más va a valer lo que yo sé hacer?
No es paranoia. Es aritmética. Cuando Claude Code resuelve issues reales de GitHub con más del 50% de éxito (Jimenez et al., 2024, ICLR), cuando Copilot escribe el 30% del código nuevo en Microsoft (Ziegler et al., 2024, Communications of the ACM), cuando un modelo razonador supera el umbral humano en razonamiento abstracto (Chollet, 2024) — la pregunta deja de ser filosófica y se convierte en presupuestaria.
Publiqué un paper académico con 50 fuentes internacionales para intentar responder esto con evidencia, no con hype. Luego amplié la base a 150 fuentes verificadas en Scopus Q1, IEEE, ACM, Nature, Science y reportes institucionales. Lo que encontré no es lo que esperaba. Ni catástrofe ni paraíso. Algo más incómodo: una reconfiguración silenciosa que ya está ocurriendo.
Parte I: El estado del arte — qué puede hacer la IA hoy (y qué no)
Los modelos ya no solo predicen: razonan
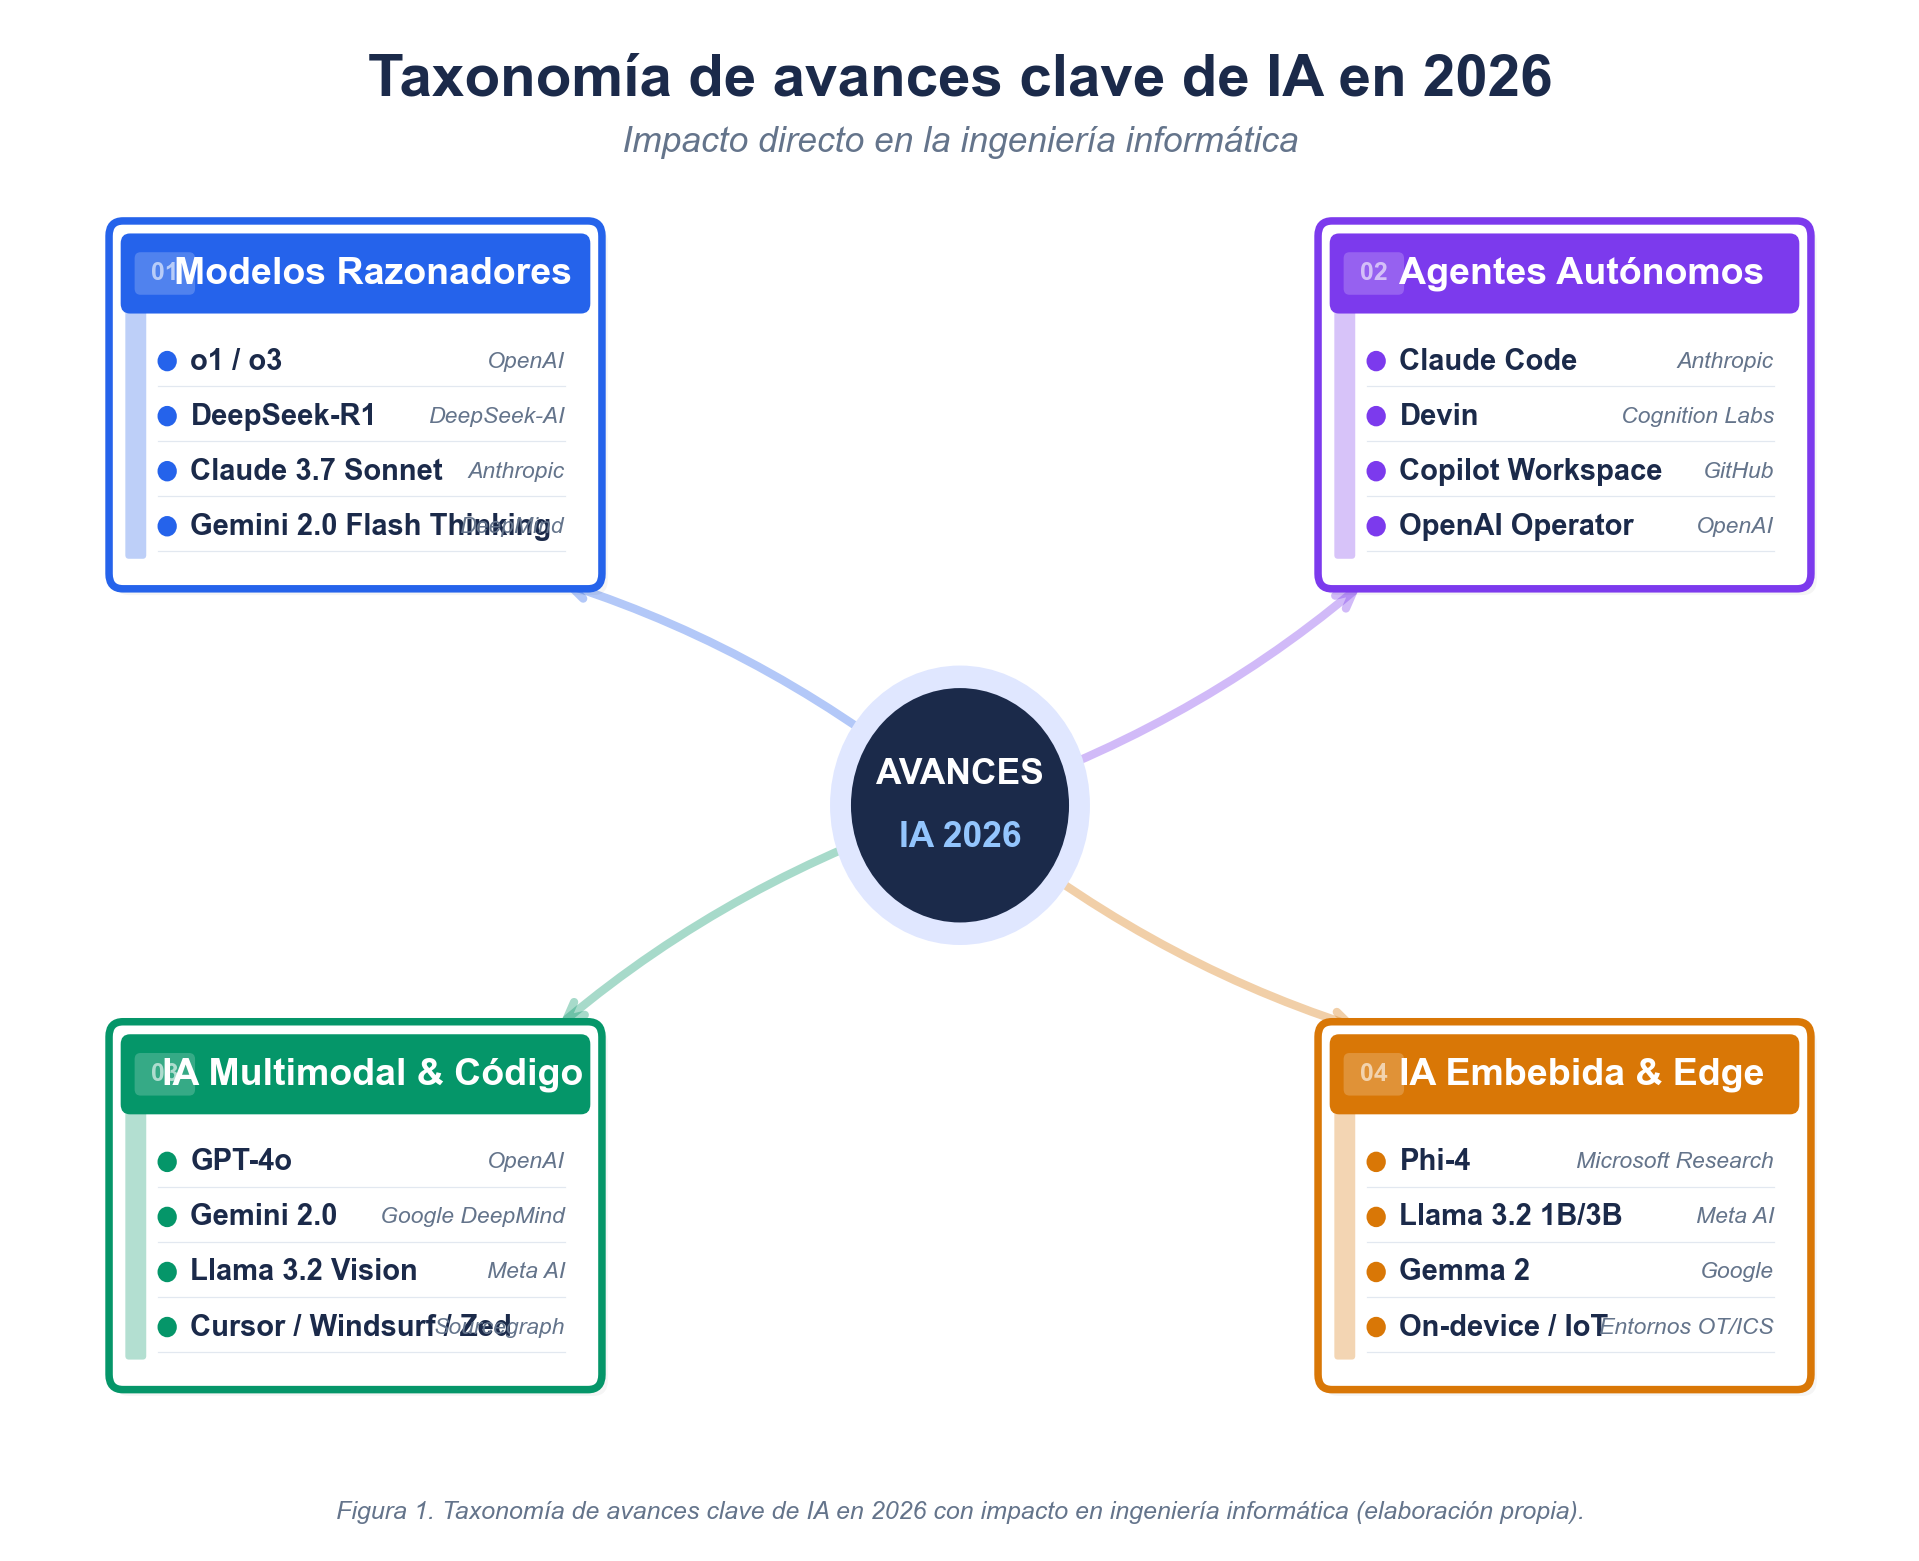
La transición de 2024-2026 no es incremental. Es cualitativa. Los modelos razonadores — o1, o3 de OpenAI, DeepSeek-R1, Claude 3.7 con modo extendido — introducen cadenas de razonamiento internas que cambian fundamentalmente lo que la IA puede resolver.
Wei et al. (2022, NeurIPS) demostraron con Chain-of-Thought que simplemente pedir a un LLM que “piense paso a paso” mejora dramáticamente su rendimiento en razonamiento matemático. Wang et al. (2023, ICLR) escalaron esto con Self-Consistency — generar múltiples cadenas de razonamiento y votar por la respuesta más frecuente. Yao et al. (2023, NeurIPS) fueron más lejos con Tree of Thoughts: búsqueda deliberada en un árbol de posibilidades, como un jugador de ajedrez evaluando movimientos.
¿El resultado práctico? Chollet (2024) documenta que o3 supera el umbral humano en ARC-AGI, un benchmark diseñado específicamente para medir razonamiento abstracto — algo que hace dos años se consideraba décadas fuera de alcance. Bubeck et al. (2023) lo llamaron “chispas de AGI” al evaluar GPT-4. Era hiperbólico entonces. Hoy, con o3, parece simplemente descriptivo.
Los agentes ya no asisten: ejecutan
La segunda revolución es agéntica. No hablo de chatbots que sugieren código. Hablo de sistemas que planifican, ejecutan, verifican y corrigen tareas de ingeniería de software de múltiples pasos.
ReAct (Yao et al., 2023, ICLR) estableció el patrón: razonar, actuar, observar, razonar de nuevo. Toolformer (Schick et al., 2023, NeurIPS) demostró que los modelos pueden aprender a usar herramientas externas autónomamente. Park et al. (2023, UIST) crearon agentes generativos que simulan comportamiento humano completo en entornos virtuales.
En producción: SWE-Agent (Yang et al., 2024, NeurIPS) resuelve el 12.5% de issues reales de GitHub. Con arquitecturas agénticas recientes, esa cifra supera el 50% en SWE-bench (Jimenez et al., 2024). Wang et al. (2024, Frontiers of Computer Science) y Guo et al. (2024, IJCAI) mapean un ecosistema de agentes multi-paso que ya está operativo.
La implicancia: no es que la IA pueda escribir código. Es que puede recibir un ticket de Jira, analizar el codebase, proponer una solución, implementarla, correr los tests y abrir un PR. Con supervisión humana mínima.
La generación de código ya es commodity
Chen et al. (2021) introdujeron HumanEval con Codex. Desde entonces, la carrera se aceleró exponencialmente. StarCoder (Li et al., 2023), StarCoder 2 (Lozhkov et al., 2024), DeepSeek-Coder (Guo et al., 2024), Code Llama (Roziere et al., 2023/2024) — cada generación supera a la anterior por márgenes significativos.
Liu et al. (2023, NeurIPS) introdujeron EvalPlus para evaluar rigurosamente la corrección del código generado — porque “compila y pasa los tests” no es lo mismo que “es correcto”. Los resultados mostraron que los modelos tenían más errores ocultos de lo reportado, pero la tendencia es clara: la brecha se cierra generación tras generación.
En reparación automática de programas, Xia et al. (2023, ICSE), Wei et al. (2023, ESEC/FSE) y Jiang et al. (2023, ICSE) documentan que los LLMs ya reparan bugs reales mejor que las herramientas especializadas previas. Fan et al. (2023, ICSE-FoSE) y Hou et al. (2024, ACM TOSEM) consolidan la evidencia en surveys sistemáticos: los LLMs están transformando cada fase del ciclo de desarrollo de software.
Parte II: El impacto real en el trabajo — lo que dicen los datos, no el hype
La evidencia empírica es robusta (y matizada)
Aquí es donde la mayoría de los artículos de LinkedIn se descarrilan. Toman un dato aislado y construyen una narrativa de catástrofe o de utopía. La evidencia real es más compleja.
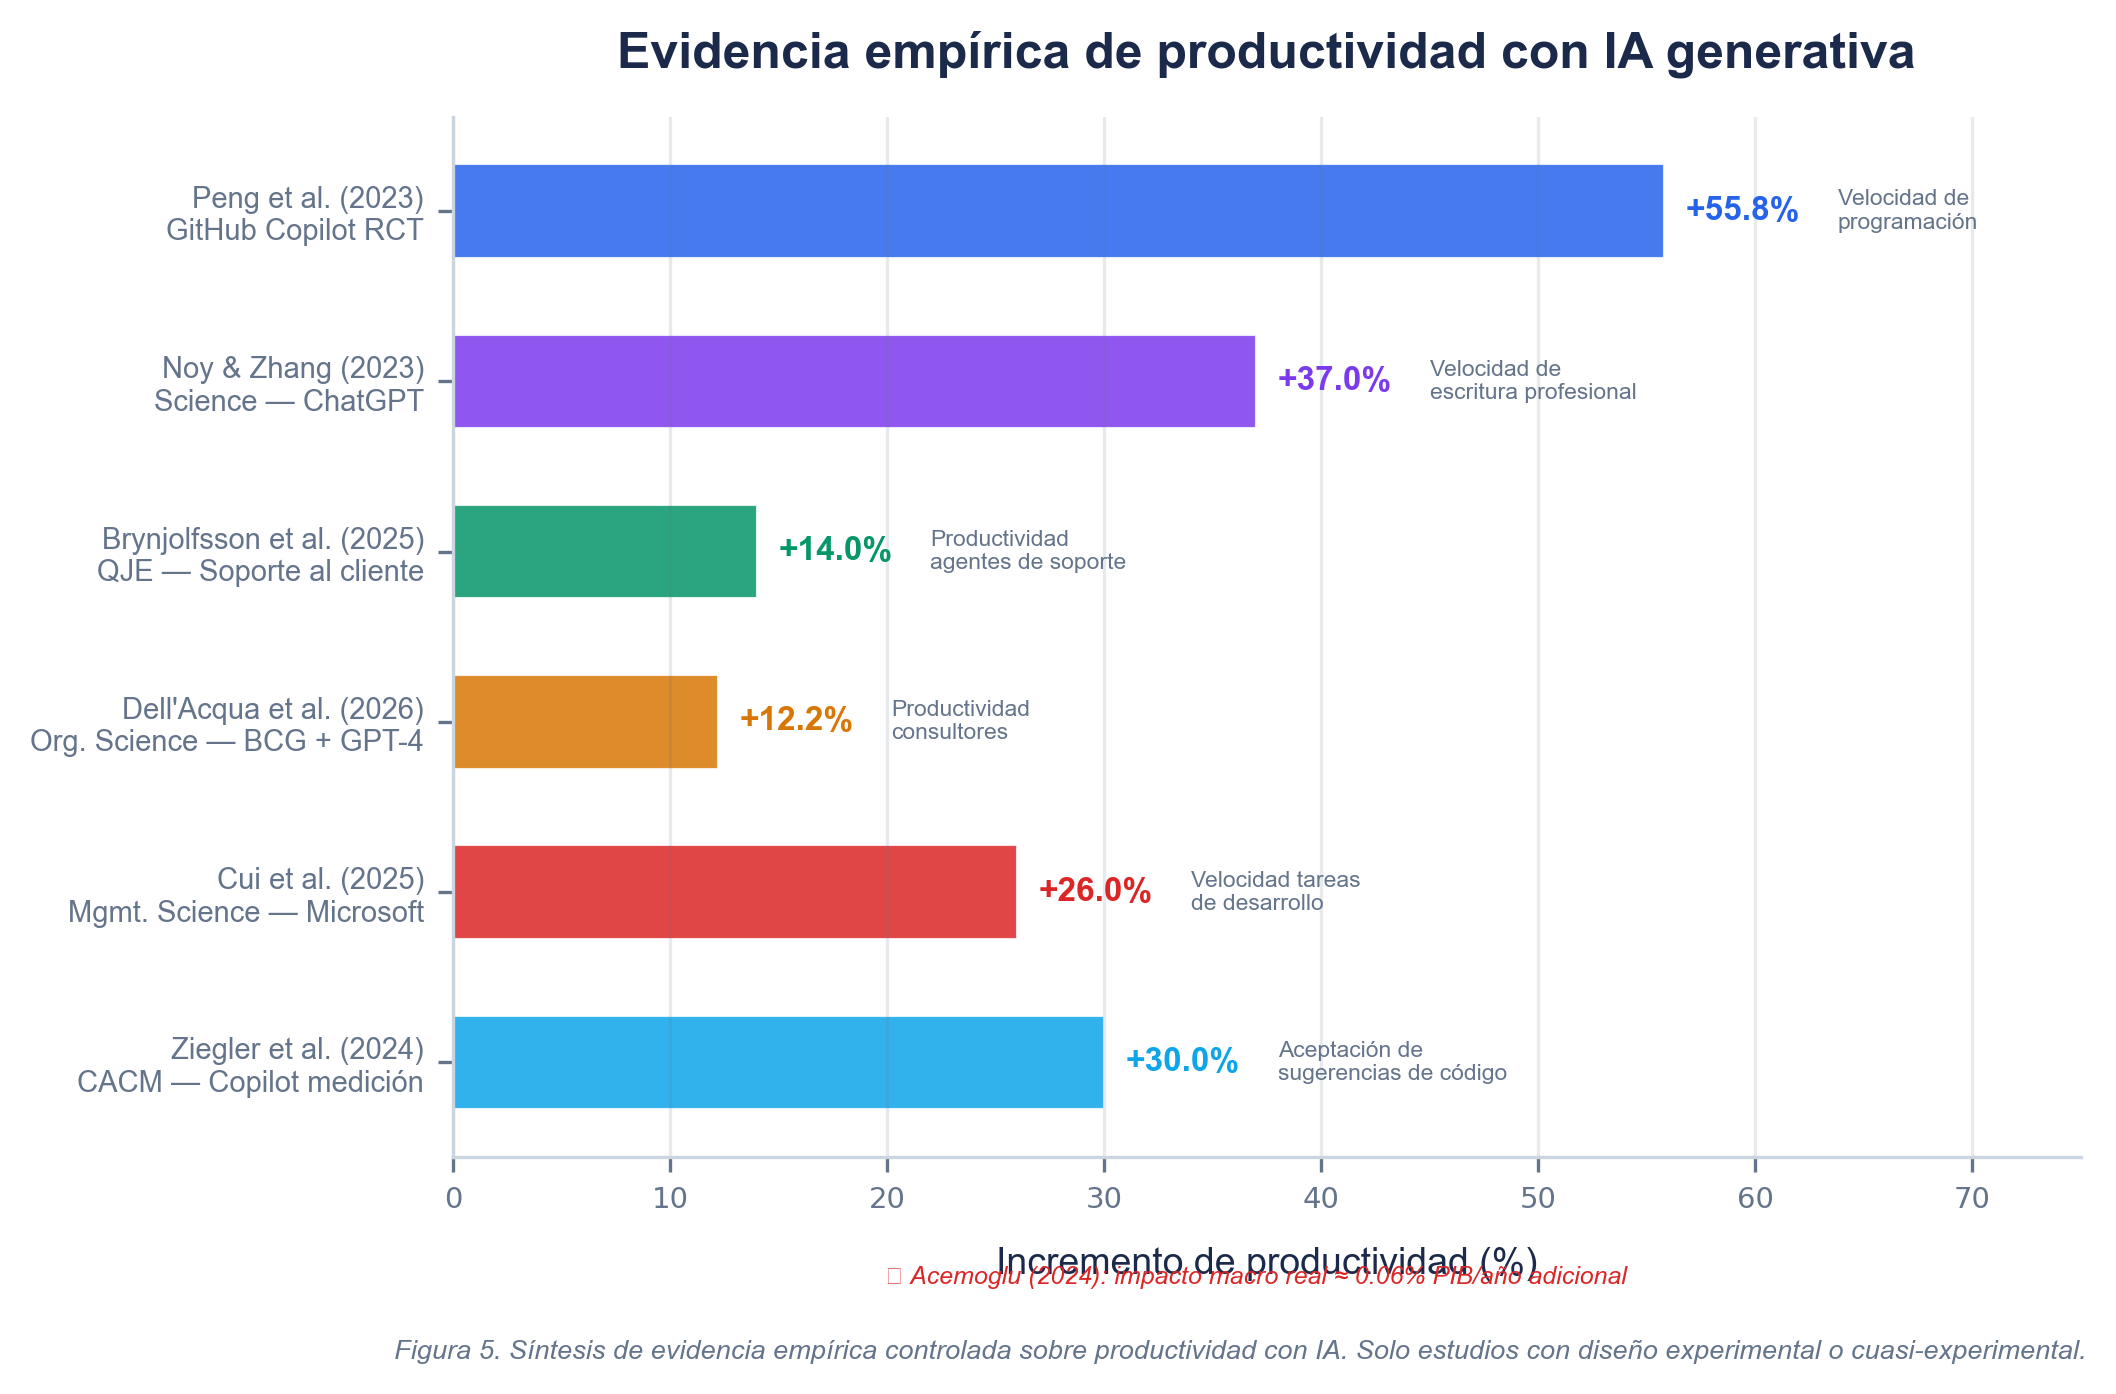
Los estudios controlados muestran ganancias reales de productividad:
- Peng et al. (2023): 55.8% más rápido con GitHub Copilot en un experimento aleatorio controlado
- Noy & Zhang (2023, Science): escritores profesionales completan tareas 37% más rápido con ChatGPT, con calidad equivalente
- Brynjolfsson, Li & Raymond (2025, Quarterly Journal of Economics): agentes de soporte al cliente con IA son 14% más productivos, con el mayor beneficio para los trabajadores menos experimentados
- Dell’Acqua et al. (2026, Organization Science): consultores de BCG con GPT-4 son 12.2% más productivos en tareas dentro de la “frontera” de la IA, pero 19% menos precisos en tareas fuera de ella
- Cui et al. (2025, Management Science): replican resultados en Microsoft, Accenture y Fortune 100 con tres experimentos de campo
Pero Acemoglu (2024, Economic Policy) pone los pies en la tierra: estima que el impacto macroeconómico real será modesto — apenas 0.06% del PIB anual adicional en el corto plazo. ¿Por qué la discrepancia? Porque hay una diferencia enorme entre “la IA puede hacer X en un lab” y “la organización Y adoptó la IA para hacer X, reentrenó a su gente, reconfiguró procesos y capturó el valor”.
La “frontera dentada” — el concepto que lo explica todo
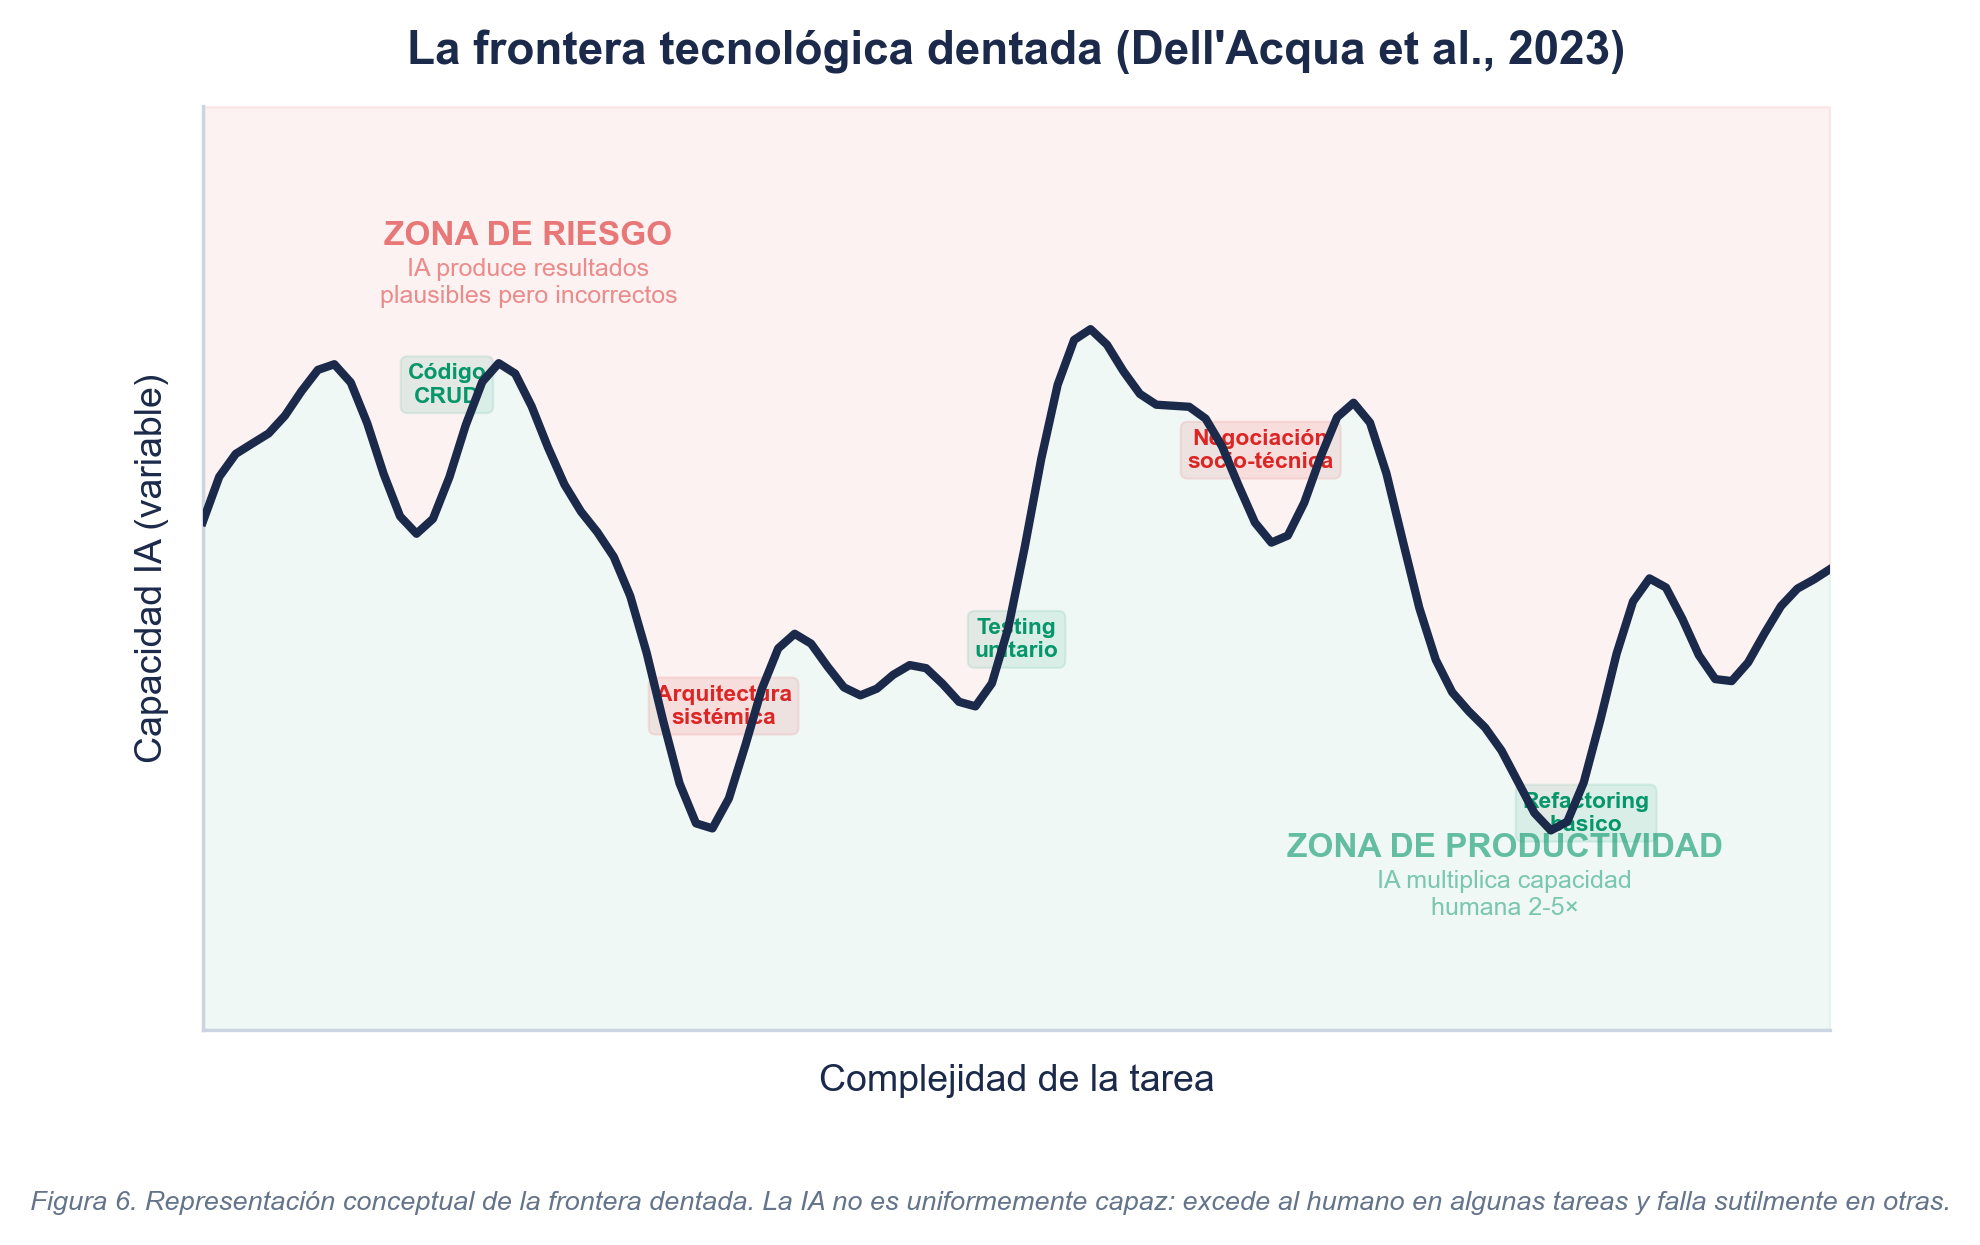
Dell’Acqua et al. acuñaron el concepto más útil para entender esta transición: la frontera tecnológica dentada (jagged technological frontier).
La IA no es uniformemente buena ni uniformemente mala en las tareas profesionales. Es extraordinariamente buena en algunas y sutilmente terrible en otras, y la frontera entre ambas zonas es irregular, impredecible y cambiante.
El problema: los profesionales que no entienden dónde está esa frontera terminan en uno de dos errores:
- Subutilización: ignoran la IA donde podría triplicar su productividad
- Sobredependencia: confían ciegamente en la IA donde produce resultados plausibles pero incorrectos
Klingbeil et al. (2024, Computers in Human Behavior) documentan el fenómeno de sobredependencia (overreliance): los humanos tienden a aceptar las respuestas de la IA sin verificarlas, especialmente cuando son plausibles. El costo de este sesgo es medible y creciente.
¿Quién gana y quién pierde? El mapa de exposición ocupacional
Eloundou et al. (2024, Science) estiman que el 80% de la fuerza laboral estadounidense verá al menos el 10% de sus tareas afectadas por LLMs. Pero “afectada” no es “eliminada”.
Acemoglu et al. (2022, Journal of Labor Economics) analizaron vacantes reales y encontraron que las empresas que adoptan IA no reducen contratación total, pero sí cambian el mix de roles que buscan. Hui et al. (2024, Organization Science) lo confirman en mercados de freelancing: la demanda de tareas rutinarias de escritura y código cayó, pero la demanda de tareas complejas de integración y arquitectura aumentó.
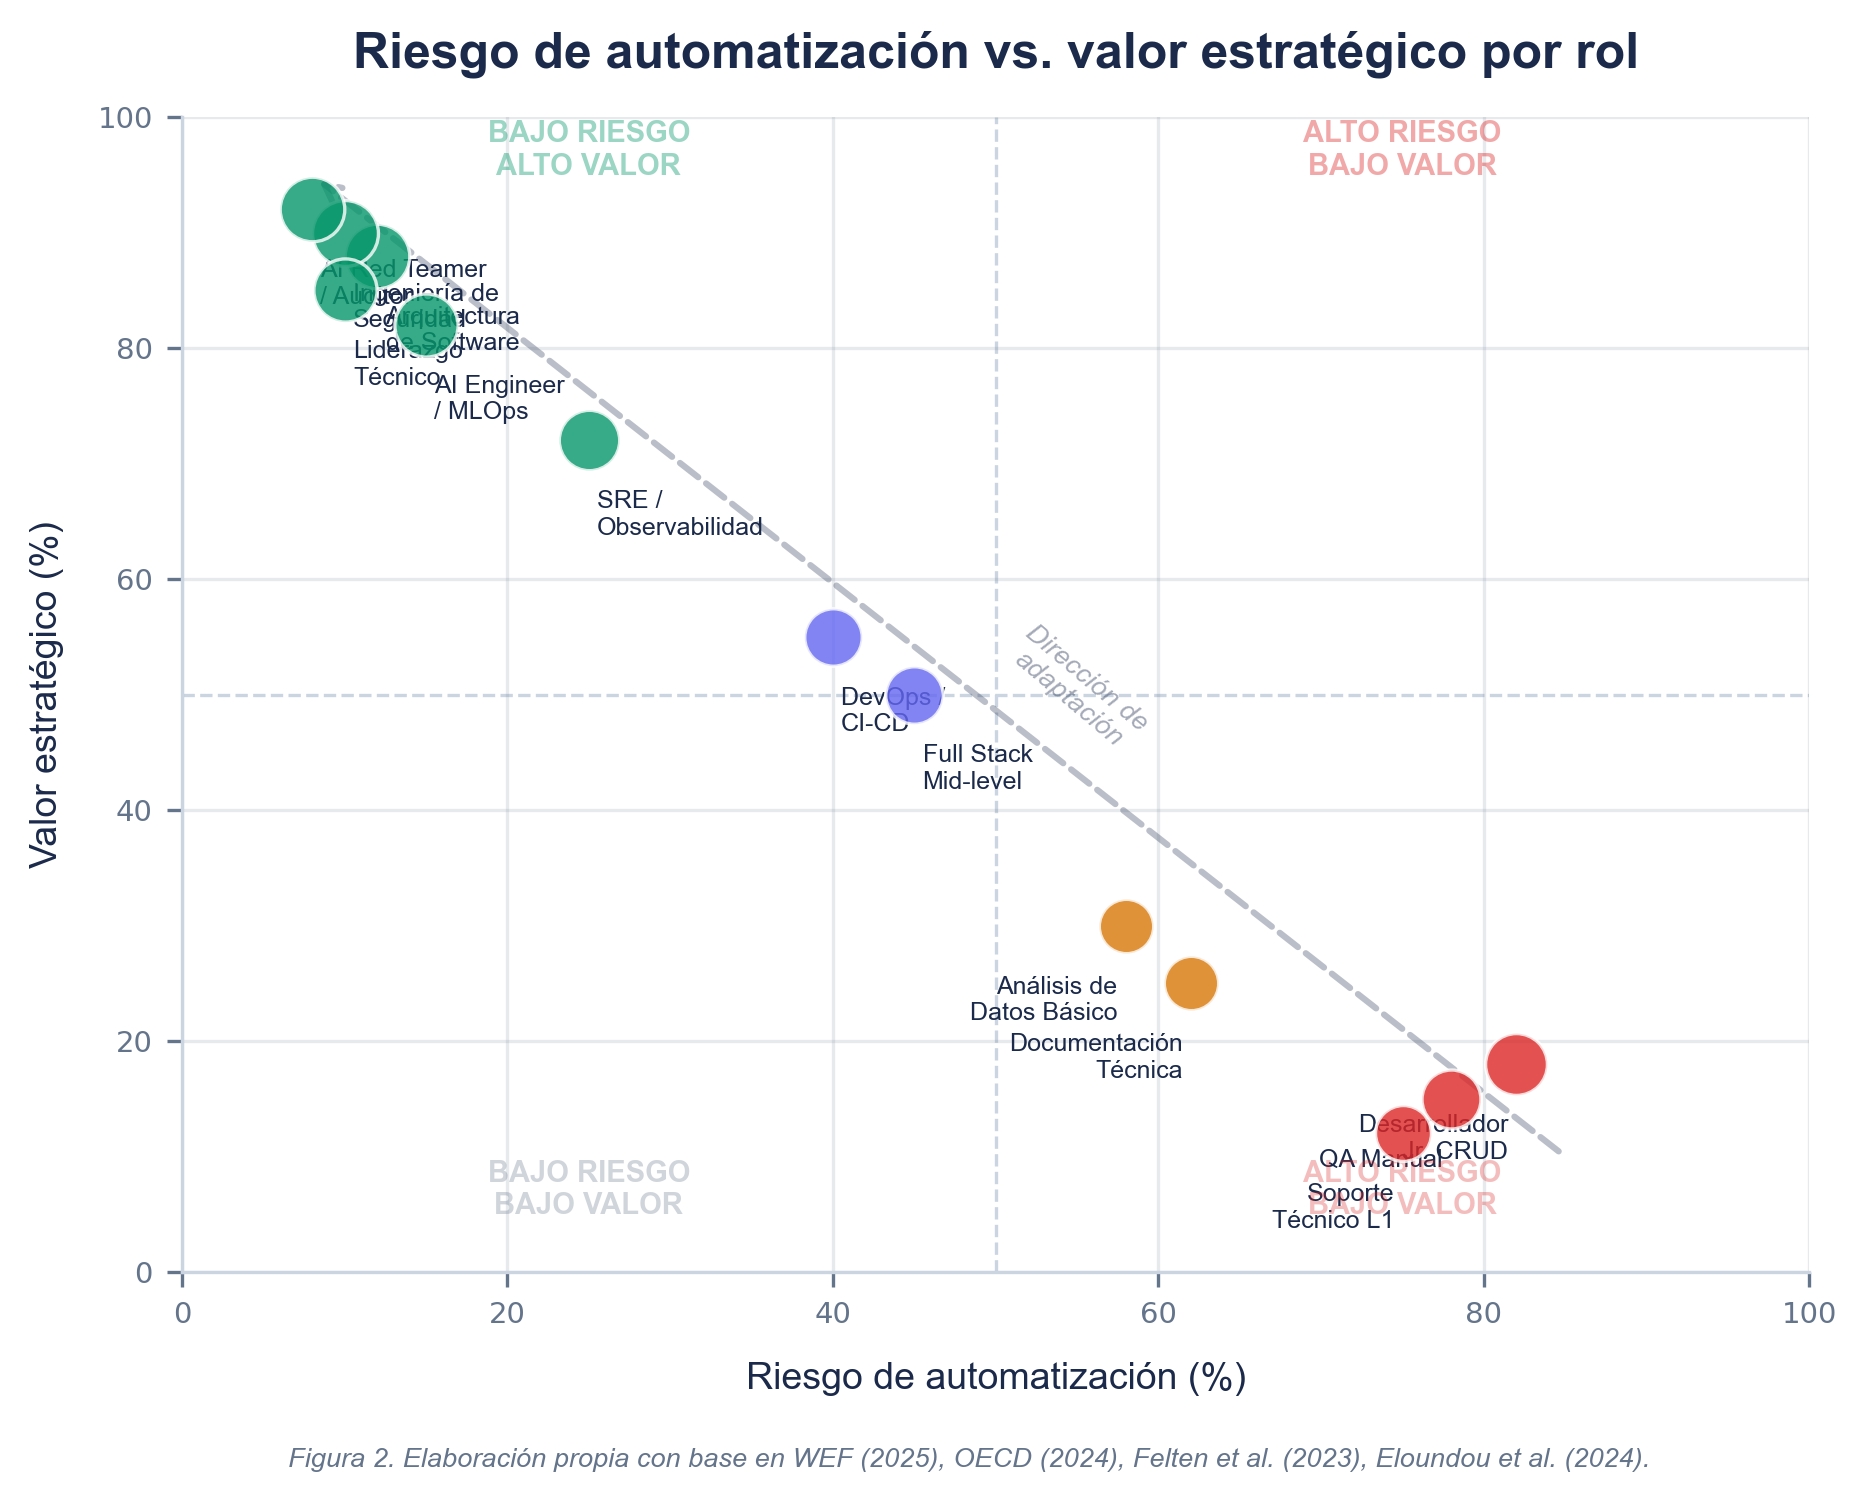
Felten et al. (2023) construyeron un índice de exposición ocupacional a IA generativa. Los roles con mayor exposición:
| Rol | Exposición |
|---|---|
| Desarrollador junior (tareas CRUD) | >70% |
| QA manual / testing básico | >70% |
| Soporte técnico L1 | >70% |
| Redacción de documentación técnica | >60% |
| Análisis de datos básico | >60% |
Los roles que ganan valor estratégico:
| Rol | Por qué gana valor |
|---|---|
| Arquitectura de software | Juicio sistémico, trade-offs, contexto |
| Ingeniería de seguridad | Superficie de ataque crece con cada agente |
| SRE / Observabilidad | Supervisar sistemas autónomos |
| AI Engineer / MLOps | Construir y mantener los sistemas de IA |
| AI Red Teamer / Auditor | Seguridad ofensiva contra modelos |
| Liderazgo técnico | Negociación socio-técnica, ética |
La línea divisoria no es “senior vs. junior”. Es juicio sistémico vs. ejecución mecánica.
Parte III: Los cuatro futuros posibles
Aplicando análisis morfológico (Godet, 2000) sobre dos variables críticas — intensidad de adopción y fuerza de gobernanza — construimos cuatro escenarios plausibles para 2030:
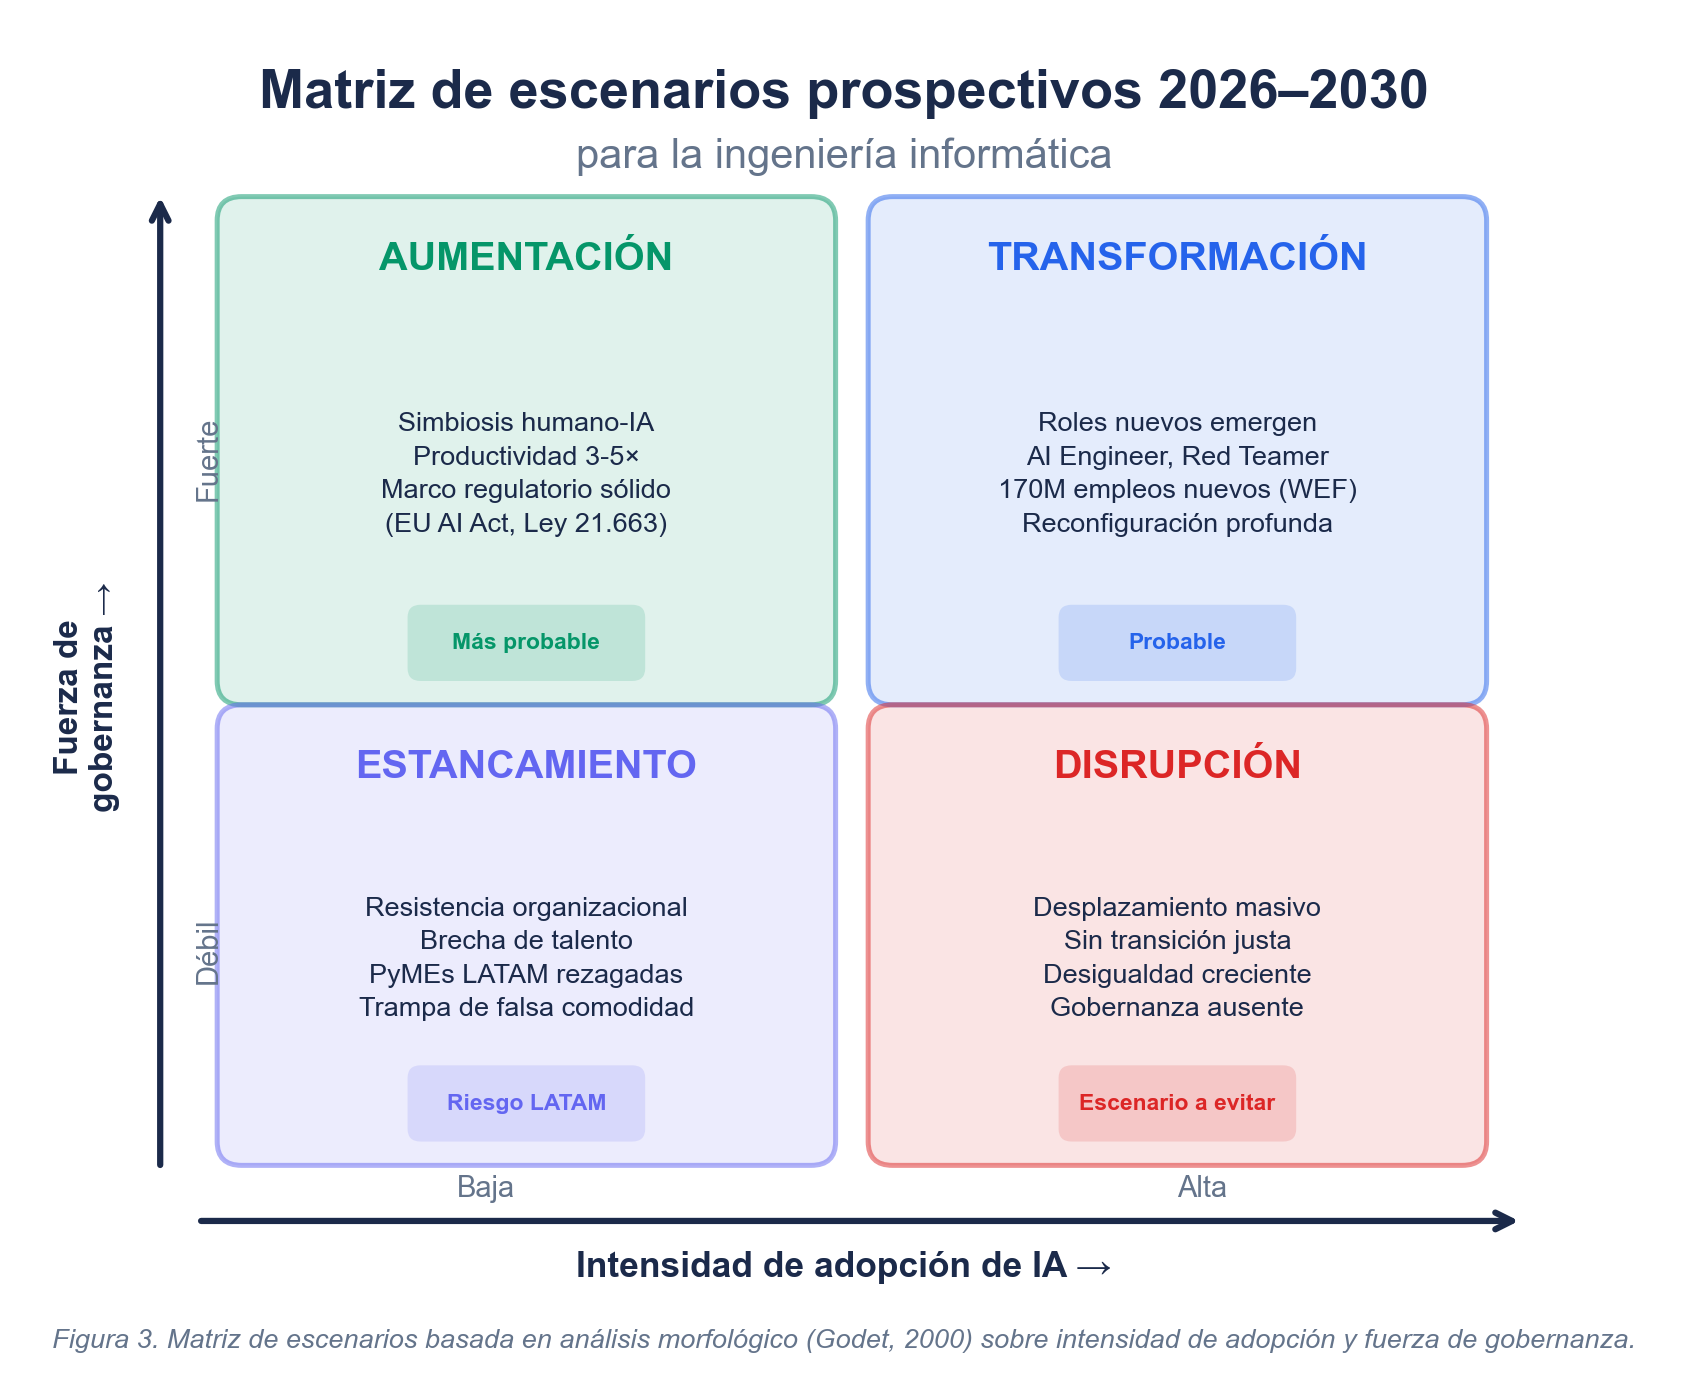
Escenario 1: Aumentación
Adopción alta + gobernanza fuerte
El ingeniero trabaja en simbiosis con sistemas IA, multiplicando productividad 3-5x. Los frameworks regulatorios como el EU AI Act (Laux et al., 2024, Regulation & Governance) y en Chile la Ley 21.663 establecen reglas claras. NIST AI RMF (Tabassi, 2023) e ISO/IEC 42001 proporcionan marcos operacionales.
Es el escenario más probable en economías con instituciones funcionales. No desaparece el ingeniero — se potencia.
Escenario 2: Transformación
Adopción alta + gobernanza con reconfiguración
Emergen roles nuevos: AI Engineer, Prompt Architect, AI Red Teamer, AI Auditor (Raji et al., 2020, FAT*; Lam et al., 2024, FAccT). El WEF (2025) proyecta 170 millones de empleos nuevos vinculados a IA. Autor et al. (2024, Quarterly Journal of Economics) documentan históricamente que el 60% de los empleos actuales no existían en 1940 — la creación de trabajo nuevo es la norma, no la excepción.
Escenario 3: Estancamiento
Adopción baja + gobernanza fragmentada
La brecha de talento y la resistencia organizacional frenan la adopción, especialmente en PyMEs latinoamericanas (CEPAL, 2024). McElheran et al. (2024, Journal of Economics & Management Strategy) documentan que solo el 5.4% de las empresas estadounidenses usan IA en producción. En LATAM la cifra es menor.
Parece cómodo, pero es una trampa: cuando la adopción llegue (y llegará), encontrará a toda una generación de profesionales sin las capacidades necesarias.
Escenario 4: Disrupción
Adopción alta + gobernanza débil
El escenario que deberías temer. Desplazamiento masivo de tareas junior y medias sin mecanismos de transición justa (Korinek & Stiglitz, 2024). Gmyrek et al. (2023, ILO) analizan el impacto global y encuentran que los países en desarrollo son los más vulnerables porque tienen menos capacidad de absorber la transición.
No porque la IA sea malvada, sino porque nadie se sentó a diseñar la transición.
Parte IV: La zona de confort que la IA viene a demoler
Aquí va la reflexión incómoda.
La IA no viene por “tu trabajo”. Viene por la versión de tu trabajo que puedes hacer en piloto automático.
Viene por el copy-paste de Stack Overflow que llamabas “desarrollo”. Viene por el testing manual que nunca automatizaste porque “funciona así”. Viene por las reuniones donde asentías sin entender el dominio del cliente. Viene por los 8 años de experiencia que en realidad eran 1 año repetido 8 veces.
Russo (2024, ACM TOSEM) estudió cómo los ingenieros de software navegan la complejidad de adoptar IA generativa en su práctica profesional. Encontró que la resistencia principal no es técnica — es identitaria. Los ingenieros que definen su valor como “escribo código” perciben la IA como amenaza existencial. Los que definen su valor como “resuelvo problemas complejos usando código como una de mis herramientas” perciben la IA como multiplicador.
La paradoja del constructor
Hay algo profundamente irónico: los ingenieros informáticos construimos las herramientas que podrían desplazarnos.
Entrenamos los modelos. Desplegamos los agentes. Optimizamos los pipelines de inferencia. Y luego nos preguntamos si esos sistemas van a necesitar que los sigamos construyendo.
Rahwan et al. (2019, Nature) argumentan que necesitamos una ciencia del “comportamiento de máquinas” — estudiar a los sistemas de IA como estudiamos el comportamiento humano. Alguien tiene que construir esa ciencia. Y tienen que ser ingenieros que entiendan tanto la máquina como el sistema humano que la rodea.
Parte V: Los 7 ejes de adaptación — con evidencia
No son consejos motivacionales. Son decisiones de carrera con papers detrás:
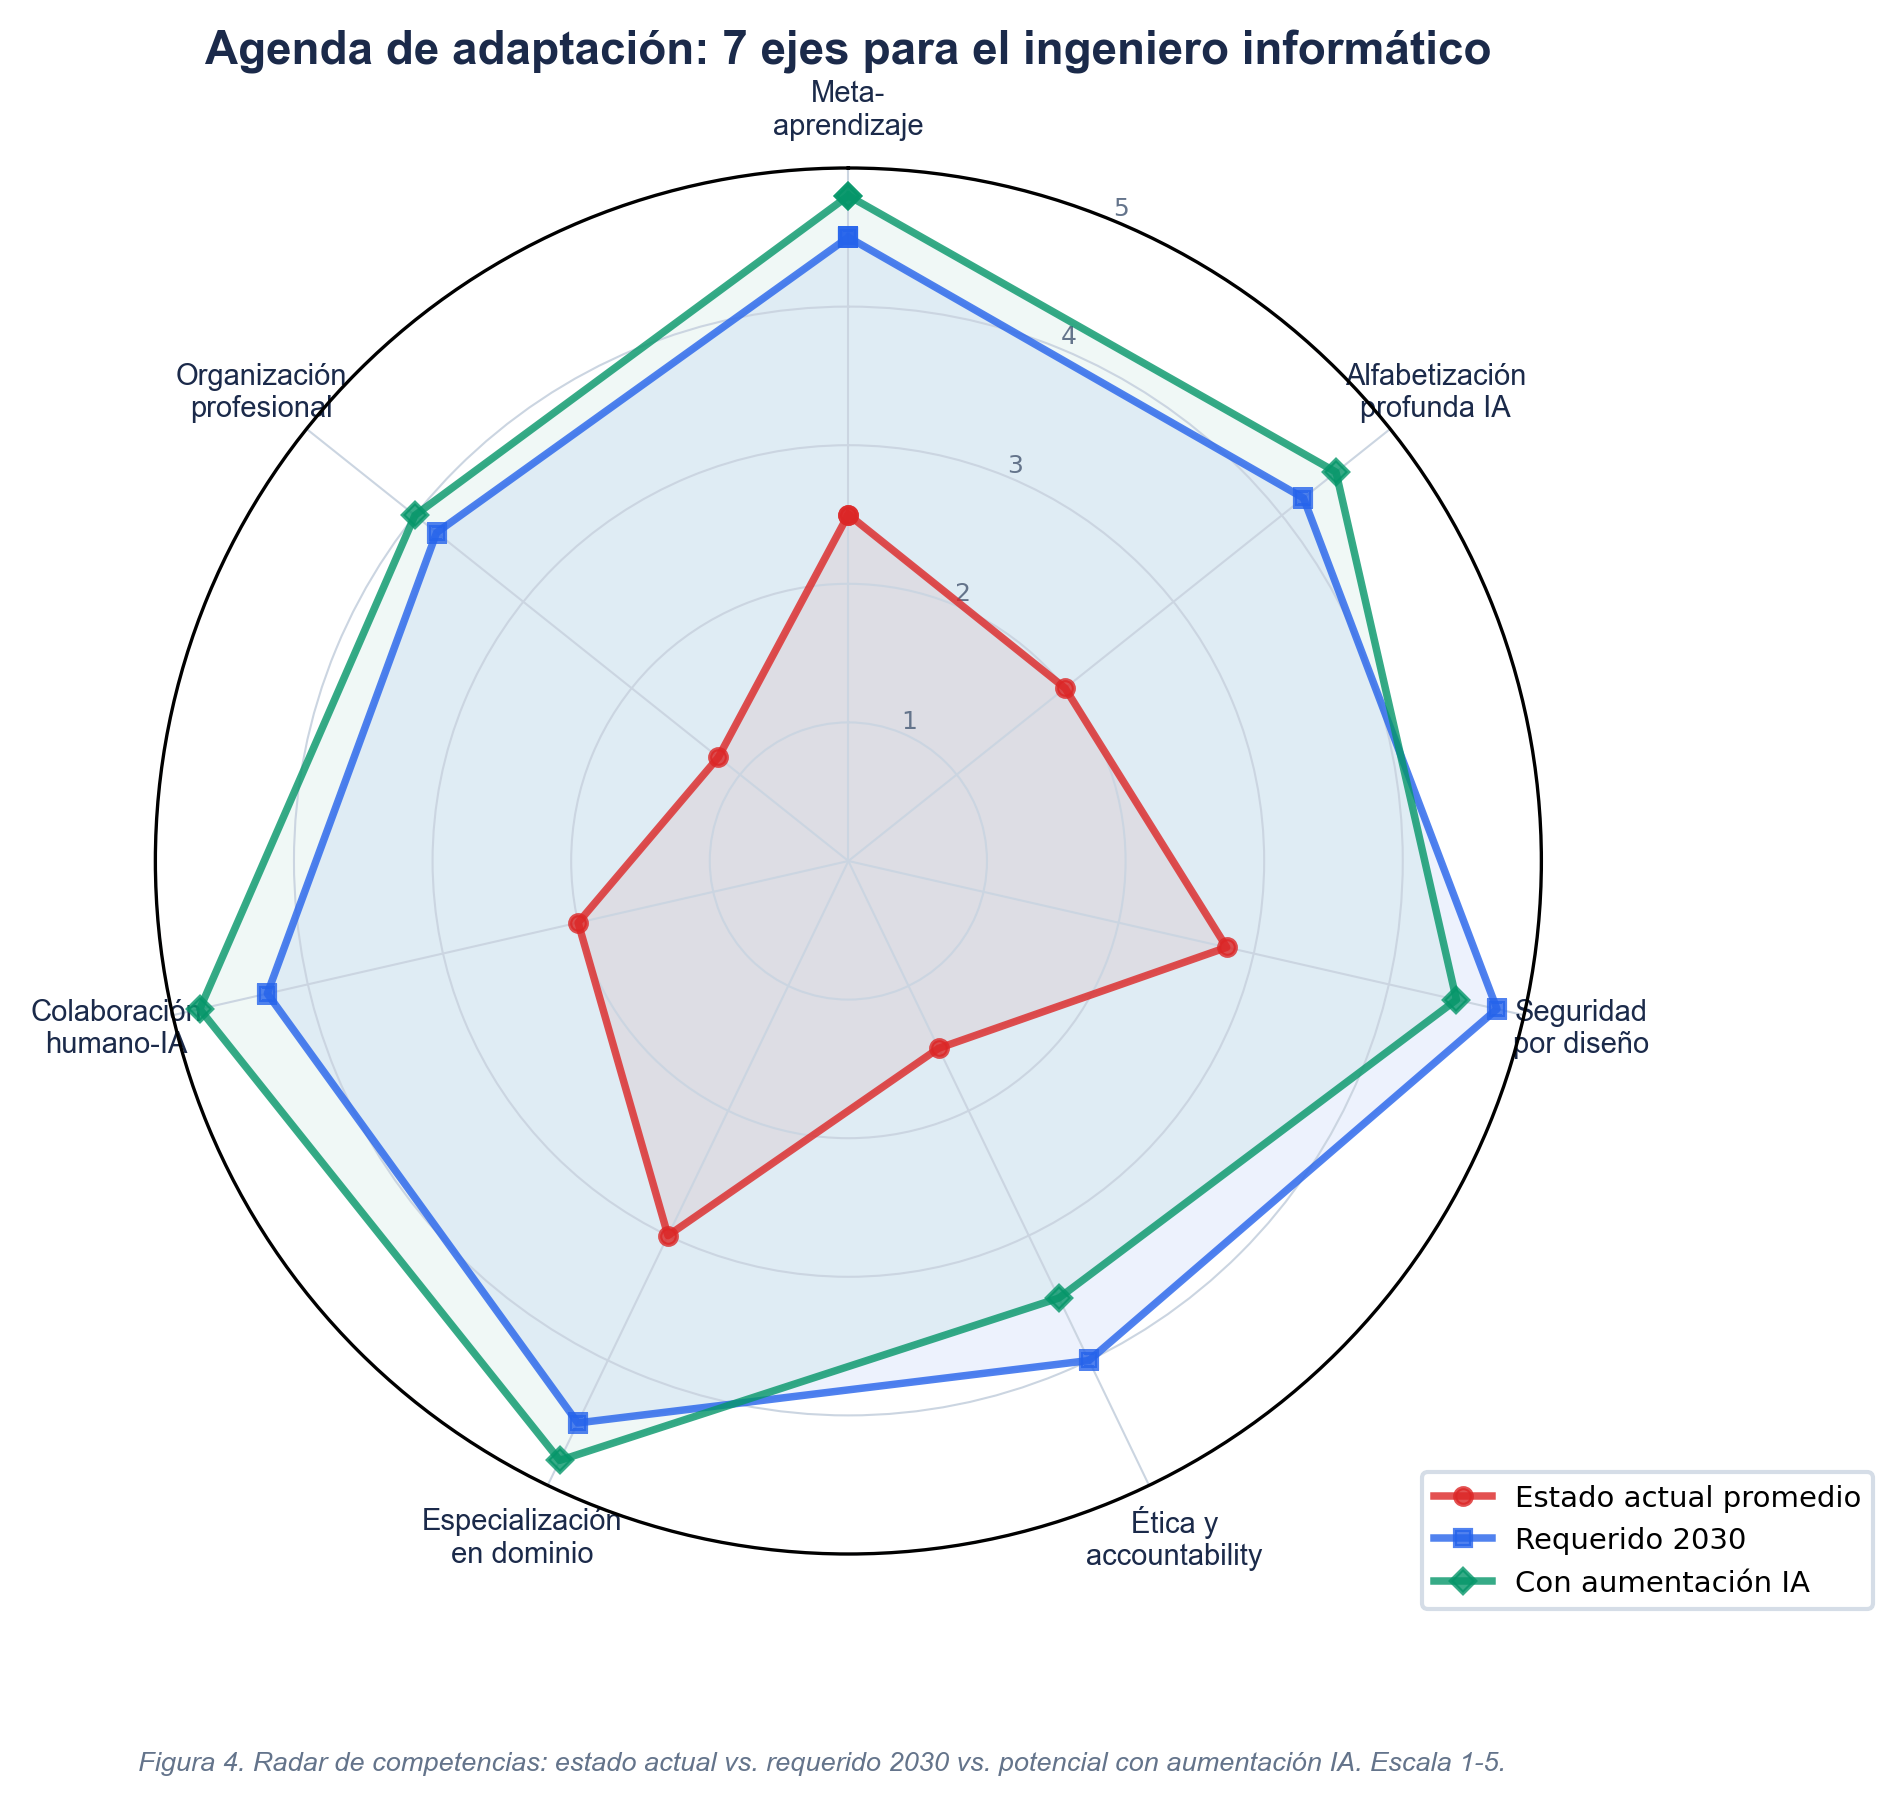
1. Meta-aprendizaje: aprender a aprender
El ciclo de obsolescencia técnica se redujo a 18-24 meses (LinkedIn, 2024). No puedes apostar a un framework. Prather et al. (2024, ICER) documentan que los estudiantes que aprenden a programar con IA generativa desarrollan menos habilidades de debugging independiente — la brecha de aprendizaje se amplía. Kasneci et al. (2023, Learning and Individual Differences) confirman que ChatGPT puede ser tanto herramienta como muleta.
Apuesta a fundamentos: matemáticas, teoría de sistemas, seguridad. Lo que no caduca.
2. Alfabetización profunda en IA
Usar Copilot no es entender IA. Ng et al. (2021, Computers and Education: AI) definen AI literacy como un constructo multidimensional: saber usar, saber evaluar, saber cuestionar. Denny et al. (2024, Communications of the ACM) argumentan que la educación en computación debe rediseñarse fundamentalmente para la era de IA generativa.
Necesitas comprender arquitecturas transformer (Vaswani et al., 2017), scaling laws (Kaplan et al., 2020; Hoffmann et al., 2022), RLHF (Ouyang et al., 2022), DPO (Rafailov et al., 2023), RAG (Lewis et al., 2020), y los límites reales de los LLMs. La diferencia entre un usuario y un profesional es saber por qué falla.
3. Seguridad por diseño y AI Security
Cada agente autónomo es una superficie de ataque nueva. Liu et al. (2024, USENIX Security) formalizan y benchmarkean ataques de prompt injection. Shi et al. (2024, ACM CCS) demuestran ataques de optimización contra LLM-as-a-Judge. Zou et al. (2023) descubrieron ataques adversarios universales y transferibles contra modelos alineados.
Kaur et al. (2023, Information Fusion) mapean el estado del arte completo de IA para ciberseguridad. MITRE ATLAS (2024) extiende MITRE ATT&CK al dominio de IA. Si dominas NIST AI RMF (Tabassi, 2023; Autio et al., 2024) e ISO/IEC 42001, estás en el 1% que las empresas necesitan desesperadamente.
4. Ética y responsabilidad algorítmica
Jobin et al. (2019, Nature Machine Intelligence) mapearon 84 guías de ética de IA globales. Hagendorff (2020, Minds and Machines) demostró que la mayoría son decorativas — principios sin mecanismos de enforcement. Raji et al. (2020, FAT*) propusieron cerrar la brecha con auditorías algorítmicas end-to-end. Mokander & Floridi (2021, Minds and Machines) diseñaron frameworks de auditoría ética operacional.
Zhao et al. (2024, ACM TIST) y Liao & Vaughan (2024, Harvard Data Science Review) mapean los desafíos de explicabilidad y transparencia específicos de LLMs. Alguien tiene que auditar estos sistemas, explicar sus decisiones, rendir cuentas. La IA no rinde cuentas. Tú sí. Eso es valor.
5. Especialización en dominio
Saber programar es commodity. Saber programar y entender la regulación eléctrica, o el flujo clínico de un hospital, o los protocolos ICS de una planta — eso es irremplazable. Tambe (2025, Management Science) demuestra empíricamente que la combinación de domain expertise + AI literacy es el factor diferenciador más fuerte en el mercado laboral post-IA.
Babina et al. (2024, Journal of Financial Economics) documentan que las empresas que adoptan IA innovan más — pero solo cuando tienen talento que entiende tanto la IA como el dominio de negocio. Rammer et al. (2022, Research Policy) confirman en datos alemanes: la IA sin expertise de dominio no produce innovación.
6. Colaboración humano-IA
Bansal et al. (2021, CHI) demostraron que la IA más precisa no siempre produce los mejores equipos humano-IA. Mozannar et al. (2024, CHI) modelaron cómo los programadores realmente interactúan con asistentes de código — y encontraron que el diseño de la interacción importa más que la capacidad del modelo.
Klingbeil et al. (2024, Computers in Human Behavior) cuantifican los costos de la sobredependencia. Lei & Kim (2024, Annual Review of Sociology) argumentan que el debate “automatización vs. aumentación” es falso: ambos ocurren simultáneamente, y la proporción depende de decisiones de diseño organizacional.
7. Organización profesional y advocacy
El escenario que predomine — aumentación o disrupción — depende de decisiones de gobernanza que se están tomando ahora. Laux et al. (2024, Regulation & Governance) analizan cómo el EU AI Act implementa “trustworthiness” en la práctica. Papagiannidis et al. (2024, Journal of Strategic Information Systems) proponen un framework de gobernanza de IA responsable.
Falco et al. (2021, Nature Machine Intelligence) argumentan que la gobernanza de IA requiere auditorías independientes — y que los ingenieros deben ser parte de ese ecosistema de oversight. Gyevnar & Kasirzadeh (2025, Nature Machine Intelligence) lo sintetizan: AI safety no es solo para investigadores — es para todos.
Si no estás en la mesa donde se discuten estándares, regulación y política pública, eres parte del menú.
Parte VI: El verdadero riesgo
Después de revisar 150 fuentes, de construir escenarios, de cruzar datos de Nature, Science, Econometrica, QJE, NeurIPS, ICSE, CHI, WEF, OECD y laboratorios frontera, mi conclusión es una sola:
El riesgo no es que la IA te reemplace. El riesgo es que te quedes quieto mientras el mundo se reconfigura.
La IA no va a eliminar en bloque a los ingenieros informáticos. Pero va a hacer irrelevantes a los que confundieron saber usar herramientas con saber pensar.
Si tu propuesta de valor como ingeniero se puede resumir en “escribo código que funciona” — tienes un problema. Porque eso ya lo hace un modelo de $20/mes.
Si tu propuesta de valor es “entiendo el sistema completo — diseño soluciones que consideran seguridad, ética, regulación y personas, y puedo supervisar agentes autónomos que hacen en minutos lo que antes tomaba semanas” — entonces no solo sobrevives. Eres más valioso que nunca.
El ingeniero informático de 2030 no competirá contra la IA: trabajará con ella, la supervisará, la asegurará y responderá éticamente por ella. Eso no es menos ingeniería — es más. Es ingeniería con responsabilidad ampliada.
La zona de confort se acabó. Pero la oportunidad está abierta.
La pregunta es qué vas a hacer con ella.
Este artículo se basa en el paper académico “¿La Inteligencia Artificial desplazará a los Ingenieros en Informática? Un análisis prospectivo de los avances de la IA en 2026 y escenarios para la profesión” (Vargas-Yáñez, 2026), ampliado con 100 fuentes adicionales verificadas en Scopus Q1, IEEE, ACM, Nature, Science y reportes institucionales. El repositorio completo de referencias está disponible para investigadores.
Referencias citadas en este artículo
- Acemoglu, D. (2024). The simple macroeconomics of AI. Economic Policy, 40(121), 13-58
- Acemoglu, D., Autor, D., Hazell, J., & Restrepo, P. (2022). AI and jobs: Evidence from online vacancies. Journal of Labor Economics, 40(S1), S293-S340
- Autor, D., Chin, C., Salomons, A., & Seegmiller, B. (2024). New frontiers. QJE, 139(3), 1399-1465
- Babina, T. et al. (2024). AI, firm growth, and product innovation. J. Financial Economics, 151, 103745
- Bansal, G. et al. (2021). Does the whole exceed its parts? CHI ‘21
- Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. QJE, 140(2), 889-942
- Bubeck, S. et al. (2023). Sparks of AGI. arXiv:2303.12712
- Chen, M. et al. (2021). Evaluating LLMs trained on code. arXiv:2107.03374
- Cui, Z. et al. (2025). Effects of GenAI on high-skilled work. Management Science
- Dell’Acqua, F. et al. (2026). Navigating the jagged technological frontier. Organization Science
- Denny, P. et al. (2024). Computing education in the era of GenAI. CACM, 67(2), 56-67
- Eloundou, T. et al. (2024). GPTs are GPTs. Science, 384(6702), 1306-1308
- Falco, G. et al. (2021). Governing AI safety through independent audits. Nature Machine Intelligence, 3(7), 566-571
- Fan, A. et al. (2023). LLMs for software engineering. ICSE-FoSE 2023
- Felten, E. et al. (2023). Occupational heterogeneity in exposure to GenAI. SSRN 4414065
- Gmyrek, P. et al. (2023). GenAI and jobs: A global analysis. ILO WP 96
- Guo, T. et al. (2024). LLM-based multi-agents. IJCAI-24
- Gyevnar, B. & Kasirzadeh, A. (2025). AI safety for everyone. Nature Machine Intelligence, 7, 531-542
- Hagendorff, T. (2020). The ethics of AI ethics. Minds and Machines, 30(1), 99-120
- Hou, X. et al. (2024). LLMs for SE: systematic review. ACM TOSEM, 33(8)
- Hui, X. et al. (2024). Short-term effects of GenAI on employment. Organization Science, 35(6)
- Jiang, N. et al. (2023). Impact of code LMs on APR. ICSE 2023
- Jimenez, C. et al. (2024). SWE-bench. ICLR 2024
- Jobin, A. et al. (2019). Global landscape of AI ethics. Nature Machine Intelligence, 1(9), 389-399
- Kasneci, E. et al. (2023). ChatGPT for good? Learning and Individual Differences, 103
- Kaur, R. et al. (2023). AI for cybersecurity. Information Fusion, 97, 101804
- Klingbeil, A. et al. (2024). Trust and reliance on AI. Computers in Human Behavior, 160
- Laux, J. et al. (2024). EU AI Act and trustworthiness. Regulation & Governance, 18(1)
- Lei, Y.-W. & Kim, R. (2024). Automation and augmentation. Annual Review of Sociology, 50
- Liao, Q.V. & Vaughan, J.W. (2024). AI transparency in the age of LLMs. Harvard Data Science Review
- Liu, J. et al. (2023). Is your code really correct? NeurIPS 2023
- Liu, Y. et al. (2024). Prompt injection attacks and defenses. USENIX Security ‘24
- McElheran, K. et al. (2024). AI adoption in America. JEMS, 33(2)
- Mokander, J. & Floridi, L. (2021). Ethics-based auditing. Minds and Machines, 31
- Mozannar, H. et al. (2024). Reading between the lines. CHI ‘24
- Ng, D.T.K. et al. (2021). Conceptualizing AI literacy. Comp. & Edu.: AI, 2
- Noy, S. & Zhang, W. (2023). Productivity effects of GenAI. Science, 381, 187-192
- Papagiannidis, E. et al. (2024). Responsible AI governance. J. Strategic Info. Systems
- Park, J.S. et al. (2023). Generative agents. UIST ‘23
- Peng, S. et al. (2023). Impact of AI on developer productivity. arXiv:2302.06590
- Prather, J. et al. (2024). The widening gap. ICER ‘24
- Rahwan, I. et al. (2019). Machine behaviour. Nature, 568(7753), 477-486
- Raji, I.D. et al. (2020). Closing the AI accountability gap. FAT* ‘20
- Rammer, C. et al. (2022). AI and industrial innovation. Research Policy, 51(7)
- Russo, D. (2024). GenAI adoption in software engineering. ACM TOSEM, 33(5)
- Schick, T. et al. (2023). Toolformer. NeurIPS 2023
- Shi, J. et al. (2024). Prompt injection attack to LLM-as-a-Judge. ACM CCS ‘24
- Tambe, P. (2025). Reskilling for AI. Management Science, 72(1)
- Wang, L. et al. (2024). Survey on LLM-based autonomous agents. Frontiers of Comp. Sci.
- Wang, X. et al. (2023). Self-consistency. ICLR 2023
- Wei, J. et al. (2022). Chain-of-thought prompting. NeurIPS 2022
- Wei, Y. et al. (2023). Copiloting the copilots. ESEC/FSE 2023
- Xia, C.S. et al. (2023). Automated program repair with LLMs. ICSE 2023
- Yao, S. et al. (2023). ReAct. ICLR 2023
- Yao, S. et al. (2023). Tree of thoughts. NeurIPS 2023
- Zhao, H. et al. (2024). Explainability for LLMs. ACM TIST, 15(2)
- Ziegler, A. et al. (2024). Measuring Copilot’s impact. CACM, 67(3), 54-63